強化学習でAIを仕上げる開発者とGPUの管理者に関係する話です。一般の人が使うチャットアプリの料金や機能が変わるわけではありません。
ここで扱うのは、学習用のGPUで更新した重みを、回答を作るGPUへ送り直す作業です。この送り直しを「リフィット(refit)」と呼びます。強化学習(AIが結果を見ながら試行錯誤して学ぶ方法)では、学習用と回答用のGPUを分けて並行して動かすのが一般的です。
10TB規模の送り直しを必要な分だけに減らす
NVIDIA Developer Blogの発表によると、今の大規模な公開モデルでは、1回のリフィットで約10TBの通信が必要になります。学習のたびに行うため、モデルが大きくなるほど負担が積み重なります。
例えば、Kimi K3は2.8兆パラメーター(AIの規模を表す数)で、重みのサイズは約5.6TBです。従来の方法では、学習用GPUがまず断片を集めて全体を作り、それを全員に配ります。この「集める」と「配る」の2段階で、通信量は約11.2TBに試算されています。
受け取る側は、必要な一部だけで足りても全体を受け取ります。そのため無駄が生じます。
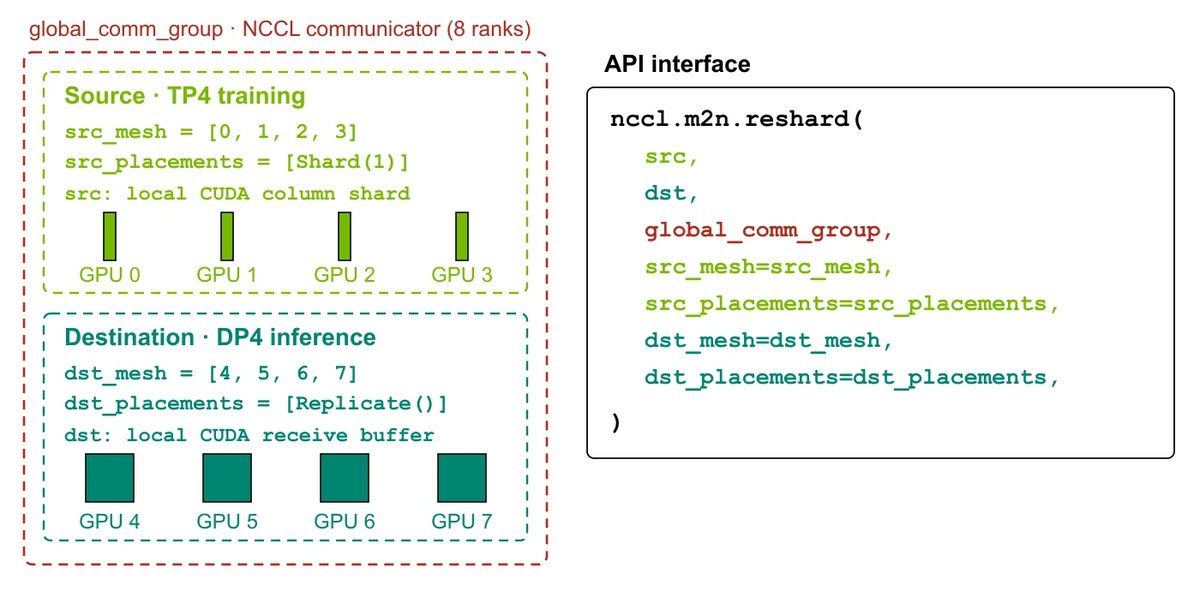
そこで登場したのが「Reshard」です。送り先ごとに必要な部分だけを、送り元から直接送る通信の仕組みです。土台にしたのは、PyTorchのDTensor(データを複数のGPUに分けて置いた配置を表す仕組み)です。
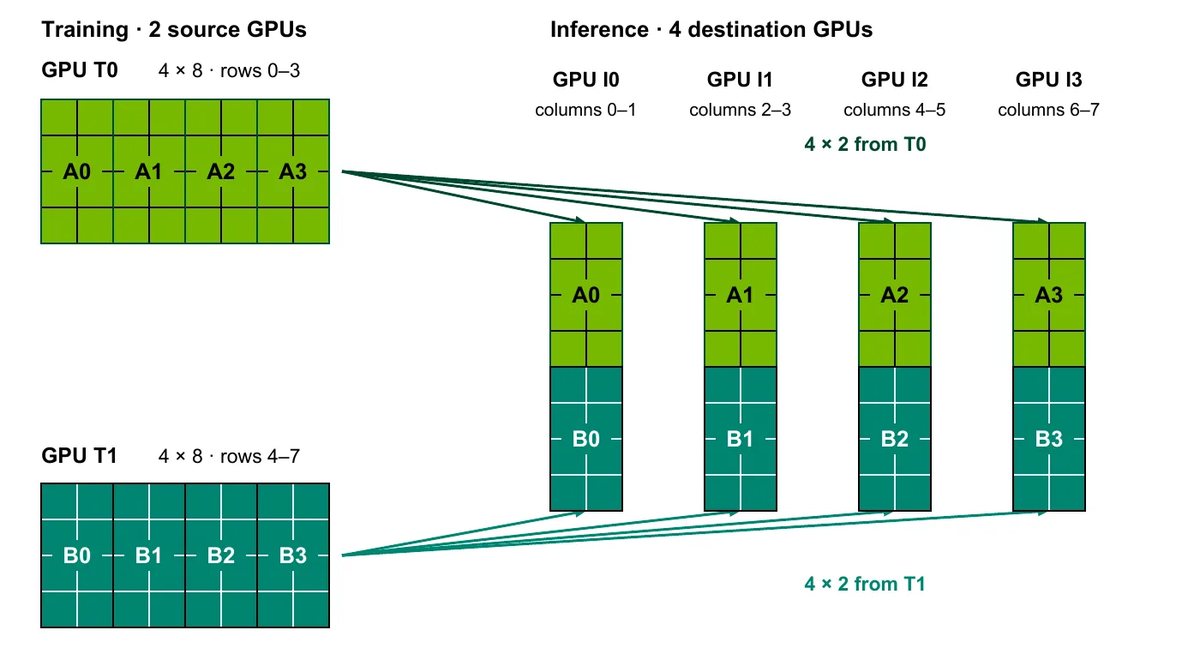
例えば、8×8の重み行列を、学習用の2台のGPUが行ごとに、推論用の4台が列ごとに持つとします。推論用の1台が必要とするのは、学習用GPUそれぞれから届く4×2の範囲だけです。発表は、理論上の最小限のデータだけを送ると説明しています。
この考え方を形にしたのが、NCCL M2N Reshard(GPU同士の通信を担うNCCLの上で動く実装)です。GitHubのNVIDIA/nccl-extensionsで公開されています。同じ部分を複数の受け手に別々に送ると通信が重なるため、受け取ったデータはNVLink(GPU同士を直結する高速な接続)を通じて受け手同士で交換します。
NVIDIAのDGX H100とDGX GB200で行われたNeMo RLのベンチマークでは、Qwen 3 235BやDeepSeek v3 671Bを含むモデルで、従来方式より2.7倍から5.7倍速くなりました。編集部の見立てでは、この数字は比較対象と測定条件とセットで読むべきです。
また、NeMo RLでは通信量の大半を占めるフィードフォワード層の重みだけをReshardで送ります。小さい重みは従来の方法のままにして、対応範囲を保ちます。