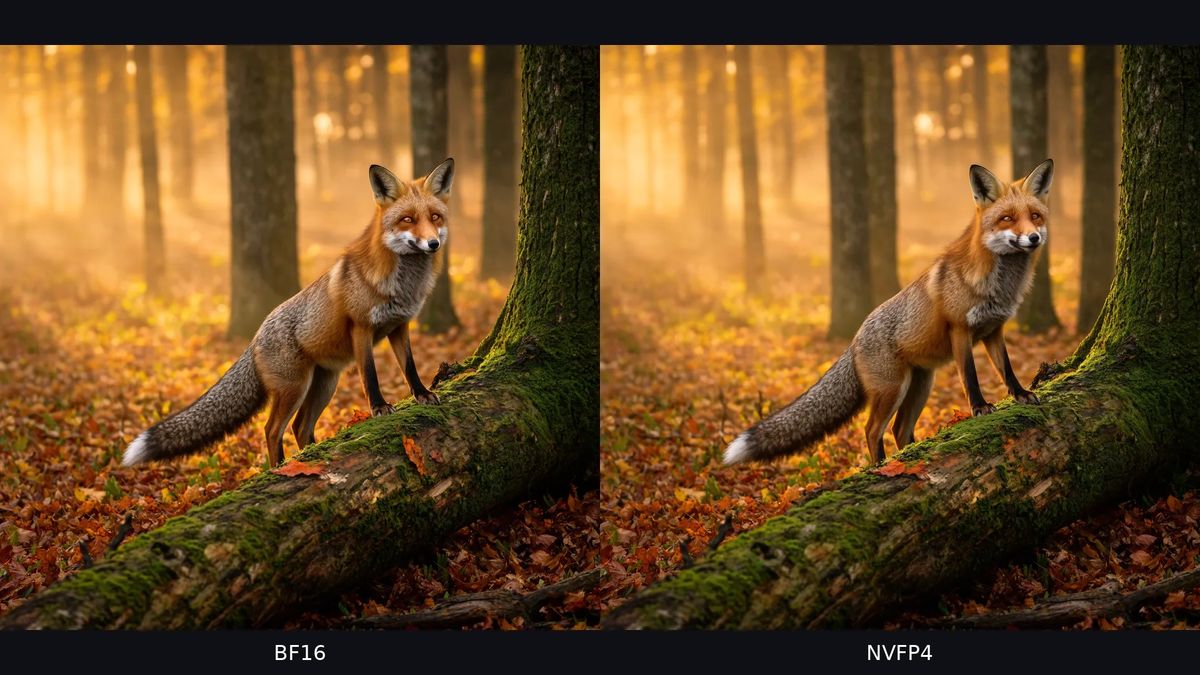
画像生成AIを自社のサービスや制作ツールに組み込んでいる開発者にとって、画像1枚ができるまでの待ち時間が短くなる話です。
一般の会社員や個人が、今すぐ変わる話ではありません。
FLUX 3 Image Kleinは、Black Forest Labs(BFL)が開発した、画像の生成と編集ができるAIモデルです。
NVIDIAの開発者向けブログによると、このモデルを速く動かす方法が示されました。速く動かす先は、NVIDIAのGPU(画像の計算を担う半導体)です。使うのは、NVIDIAの実行環境「TensorRT LLM VisualGen」です。
テキストから画像を作るとき、処理のほとんどはデノイズ(画像のもとになるノイズを段階的に取り除く処理)に使われます。
B200 1台で2048×2048の画像を作ると、Base版(50ステップ)のテキストからの生成は次のとおりでした。
- 合計: 14.70秒
- うちデノイズ: 14.24秒
まず、数値を4ビットで表すNVFP4という形式を使うと、BF16(16ビットの計算形式)と比べて速くなります。テキストからの生成は最大1.62倍、画像からの生成は最大1.58倍速くなりました。
さらに工夫を重ねると、最適化なしのBF16と比べて速くなります。
- テキストからの生成: 最大3.46倍
- 画像からの生成: 最大4.45倍
どちらもB200 1台で2048×2048の画像を作った場合の数字です。
最適化の効果を数字で見る
速さを上げる工夫は、主に次の4つです。数字はBase版のものです。画質の変化は、LPIPS(画像の見た目の違いを示す指標。0に近いほど元の画像に近い)で示されています。
- 量子化アテンション(cuDNN FP8): 1.08倍、LPIPSは0.072
- VC-Attention FP8(誤差を補正する方式): 1.18倍、LPIPSは0.086
- Sol-Attention(計算を間引く方式): 1.30倍。最初の12ステップは通常の計算を使います
- Cache-DiT(途中の計算結果を使い回す方式): 2048×2048で1.94倍、LPIPSは0.033
ここで効くのは、アテンション(画像の各部分どうしの関係を計算する部分)です。
VANILLA BF16(最適化なしの標準的な計算)では、この計算が大きな割合を占めていました。具体的には、DiT(拡散トランスフォーマー。画像を作るモデルの中心部分)のGPUの処理時間の約60%です。
8枚のB200で分担させると、テキストからの生成の中央値は次のとおり縮みました。
- Base版: 14.90秒から3.00秒へ
- 蒸留版(少ない手順で答えを出せるよう軽くした版): 2.73秒から1.08秒へ
デノイズだけなら、Base版は6.01倍、蒸留版は4.44倍速くなります。ただ蒸留版は、全体時間の約半分がデノイズ以外に残るため、全体の短縮は小さくなります。
編集部の見方では、速さの数字と並べて画質の変化を数値で示している点が、この発表の読みどころです。
Sol-Attentionでは、τ(タウ。間引きの強さを決める値)を上げると、画質が下がります。それなのに、速さの伸びは小さいとされています。
同じNVIDIAの「TensorRT Edge-LLM」は、手元の機器で動くAI(エッジAI)の開発向けです。サイソクは11月2日に報じています(エッジAI開発を数コマンドで始められる「TensorRT Edge-LLM」)。