メタデータ駆動で開発を効率化
AIアシスタントやエージェントごとに独自のSQL生成ロジックや接続設定を実装すると、データ構造が変わるたびにすべてのエージェントを修正する手間が生じます。 今回公開された構成では、JSON形式のメタデータファイルを用意するだけで、サーバーが自動的にデータセットを認識して検索できるようになります。 基盤のレイヤーで認証やアクセス制御(SELECT文のみの許可など)を一元管理するため、セキュリティを保ったまま新しいデータを迅速に追加できます。
 画像はイメージ(AI生成)
AI生成画像はイメージです。記事で紹介している製品・人物・場所を写したものではありません。
本ページはプロモーションを含みます
AWSがAmazon ECS Fargateで動くサーバーレスなMCPサーバーの構築アーキテクチャを公開しました。
要約版:専門用語を控えて説明しています
AIアシスタントやエージェントごとに独自のSQL生成ロジックや接続設定を実装すると、データ構造が変わるたびにすべてのエージェントを修正する手間が生じます。 今回公開された構成では、JSON形式のメタデータファイルを用意するだけで、サーバーが自動的にデータセットを認識して検索できるようになります。 基盤のレイヤーで認証やアクセス制御(SELECT文のみの許可など)を一元管理するため、セキュリティを保ったまま新しいデータを迅速に追加できます。
AI(人工知能)を活用したアプリケーション開発では、大規模言語モデル(LLM)のエージェントに企業のデータレイクを接続する作業が課題となっています。多くのチームは、エージェントをデータベースやAPIに直接つなぐ方法から始めます。
データセットやエージェントが増えると、アクセス権限の管理がばらつきやすくなります。新しいデータソースの追加にも、数日間の開発作業が必要になることがありました。
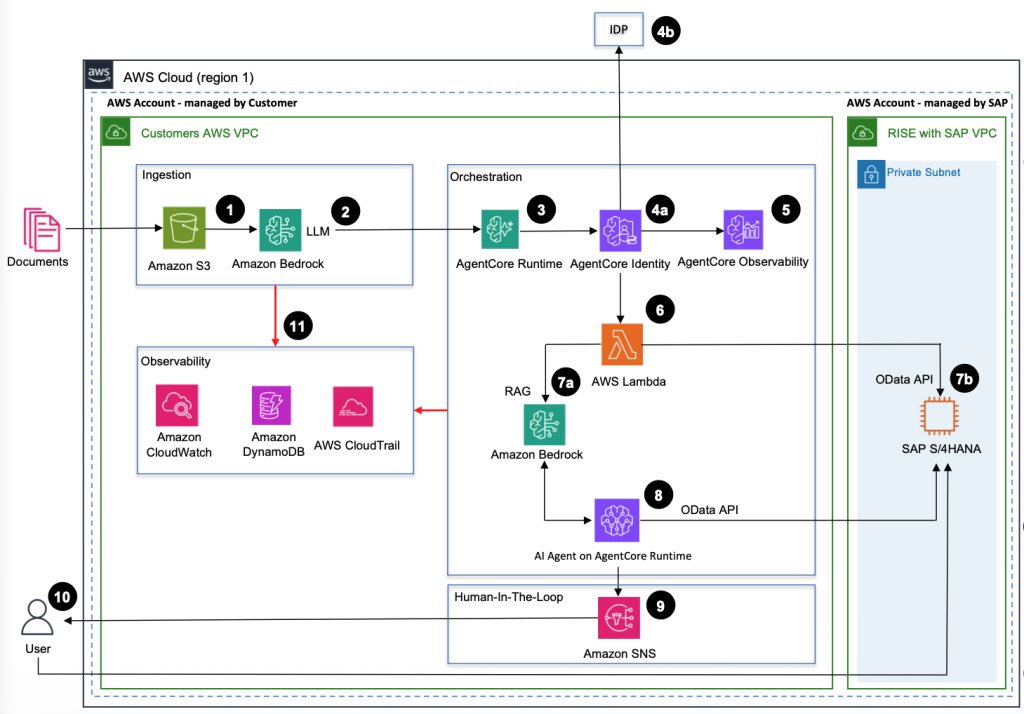
AWSの機械学習ブログでは、Amazonの北米ソートセンター(NASC)ネットワークの計画チーム向けに構築した、サーバーレスなModel Context Protocol(MCP)サーバーの構成を紹介しています。サーバーはAmazon ECS Fargate上で動作し、AIエージェントと企業データレイクの間を仲介する、エージェント非依存の集約型ゲートウェイとして機能します。
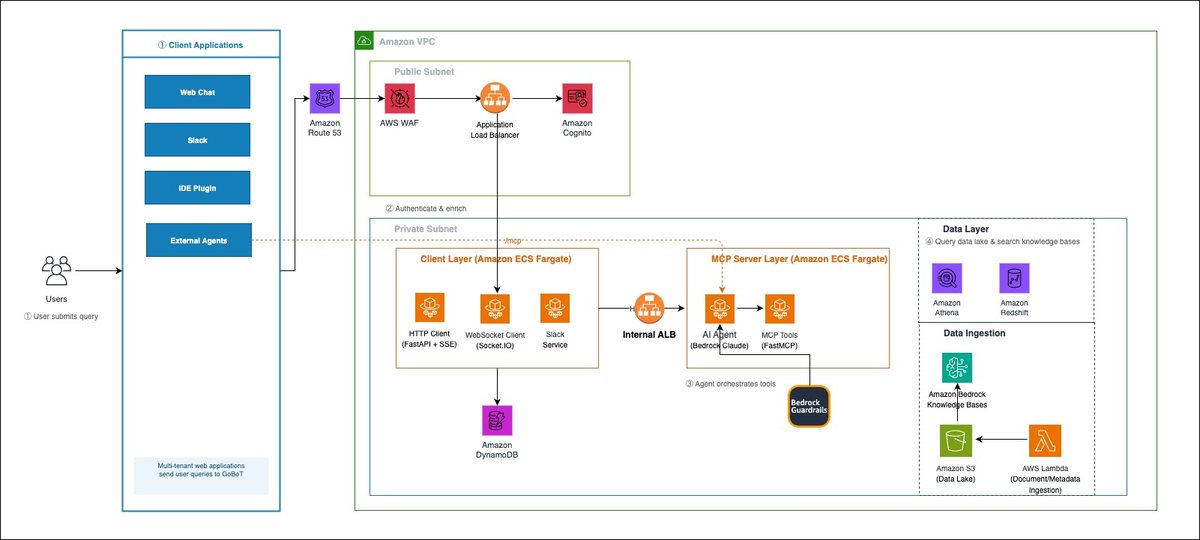
アーキテクチャは、クライアント、MCPサーバー、ツール、知識ベース更新の4つの層に分かれています。それぞれを独立して拡張・デプロイできます。クライアントからのリクエストは、まずAmazon Route 53を介してDNS解決されます。
その後、HTTPSとAWS WAFを設定したApplication Load Balancerを経由し、Amazon ECS Fargate上のクライアントサービスに届きます。Amazon CognitoがJWT認証を行い、セッション状態はAmazon DynamoDBに保存されます。
MCPサーバー層は、クライアント層から分離された独自のAmazon ECS Fargateクラスターで実行されます。プライベートサブネット内の内部Application Load Balancerを経由してリクエストを受け付け、Amazon Bedrockを活用したエージェントがクエリ分析、ツール選択、実行、応答生成を統括します。外部のMCP対応クライアントは、FastMCPを利用したJSON-RPCインターフェースからツールを直接利用することもできます。
Amazon Bedrock Guardrailsは、すべてのモデルとのやり取りに適用されます。有害なコンテンツのフィルタリングや、プロンプトインジェクションの試行を防ぐための機能を備えています。
公式ページでは、アクセス制御はMCPサーバー層で一元的に行うと説明されています。個々のエージェントに権限を任せると、権限の適用がずれていくことが課題として挙げられています。
出典・aws.amazon.com今できること自社の設計で、データへのアクセス制御をエージェントごとではなく一か所にまとめられるか確認する
公式ページでは、新しいデータセットの追加にはメタデータJSONファイルだけで足り、コードの変更は不要と説明されています。サーバーは次のパイプライン同期で自動的にファイルを見つけるとしています。
出典・aws.amazon.com今できること新しいデータセットを足す前に、テーブルの説明とカラムごとの説明・サンプル値をまとめたJSONを作る
公式ページでは、Fargateのタスクはステートレスで、会話の状態はDynamoDBに保存されると説明されています。そのためタスクを入れ替えたりスケールしたりしてもデータは失われないとされています。
出典・aws.amazon.com今できること会話履歴を保存する場所を決め、タスクを入れ替えても消えない設計になっているか確認する
公式ページでは、Amazon Bedrock Guardrailsがすべてのモデルとのやり取りに適用され、有害なコンテンツのフィルタリングとプロンプトインジェクションのブロックを行うと説明されています。
出典・aws.amazon.com今できることAIにつなぐ前に、入力と出力をフィルターする仕組み(Bedrock Guardrailsなど)を必ず入れる
新しいデータセットの追加に、データセットごとの統合コードは不要です。テーブルのスキーマや業務上の文脈を記述したメタデータJSONファイルを用意します。必要に応じて、業務上の文脈とデータセットを結び付ける設定も追加できます。
パイプラインがメタデータを読み込み、Amazon Titan Text Embeddingsでベクトル埋め込みを生成します。生成した埋め込みは、Amazon Bedrock Knowledge Basesにインデックス化されます。
メタデータの例には、テーブル名や所属するデータベース、テーブルの業務上の説明が含まれています。カラムごとの説明とサンプル値も記述します。
例えば注文IDのカラムには、チェックアウト時に付与される一意の識別子であるという説明と、値の例が登録されます。
エージェントはクエリ時にカタログを参照し、スキーマやカラムの意味を把握します。その情報を基にSQLを生成し、Amazon AthenaやAmazon Redshiftでクエリを実行できます。
原因の話ではなく、AIエージェントが企業データレイクに接続する設計の公開です。データセットやエージェントが増えると権限管理が煩雑になり、新しいデータの追加に数日の工数がかかっていた課題を解決するためとされています。
出典・aws.amazon.comAWSの機械学習ブログで、サーバーレスMCPサーバーの全体構成と設定例を確認する
新しいデータセットを足す前に、テーブルの説明とカラムごとの説明・サンプル値をまとめたJSONを作る
発表内容をもとにした一般的な情報です。導入や契約の判断は、公式情報を確かめたうえでご自身で行ってください。
AWS環境でAIエージェントとデータレイクを接続する基盤設計の参考として、公式ブログの構成を確認するとよいでしょう。
11/9時点の判定。発表内容をもとにAIで判定しています。最新の提供状況は公式情報をご確認ください。
 AI生成同じ話題の記事提供前AWS、
前日に出た記事から大きな発表を選び、1本2行でまとめてメールで届けます。無料・いつでも解除できます。
主要企業の大きな発表だけ、1日4回まで。夜22時〜朝7時は鳴らしません。いつでも解除できます。
本記事は公式発表の文章をもとにAIが要約・解説して自動生成したものです。誤りが含まれる可能性があるため、正確な仕様・料金は公式発表をご確認ください。元記事を読む制作方法と事実確認の手順は編集方針をご覧ください。誤りのご指摘はお問い合わせから受け付けています。