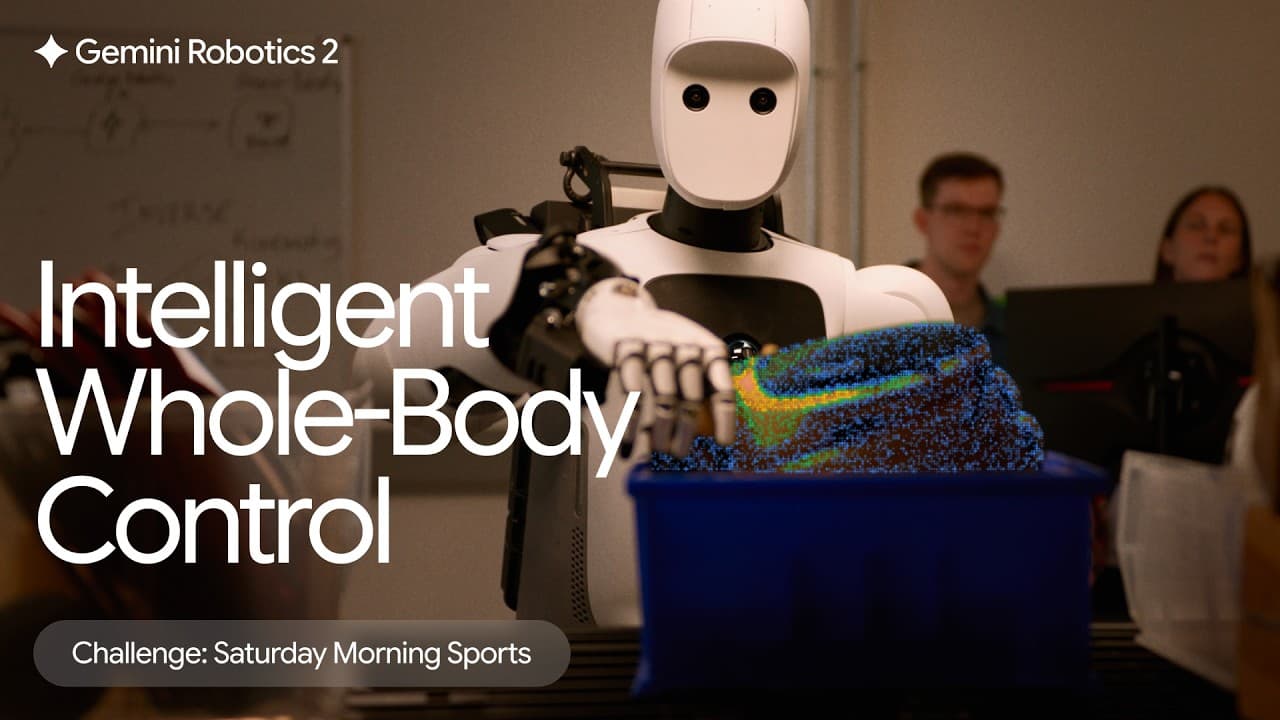
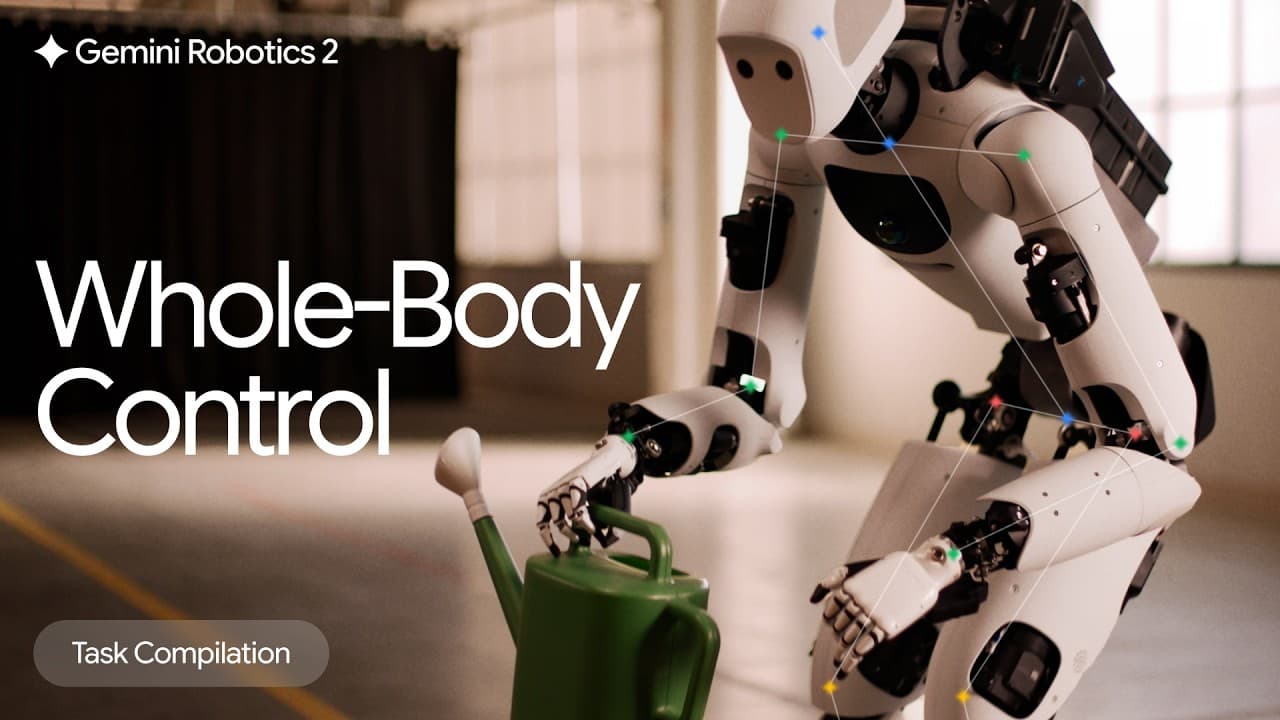
Google DeepMindは、人型ロボットの全身協調制御を自動化する最新フィジカルAIモデル「Gemini Robotics 2」を発表しました。従来の卓上作業を中心とした上半身制御から進化し、二足歩行や姿勢保持、複雑な姿勢での物体操作までを単一のAIアーキテクチャで統合します。自然言語による口頭指示とカレンダー情報を組み合わせ、自律的な判断と行動をリアルタイムで実行可能です。
何が発表されたのか
Google DeepMindは、人型ロボット(ヒューマノイド)をはじめとする物理ロボットの全身運動を高度に制御する新世代のAI基盤「Gemini Robotics 2」を発表しました。前世代の「Gemini Robotics」では、主にテーブルの上に置かれた物体を操作するような、上半身およびマニピュレータを中心としたタスクの制御が主体でした。これに対し、今回のGemini Robotics 2は「全身協調制御(Intelligent Whole-Body Control)」へと対応範囲を拡大させています。
動画内で示された研究ディレクター兼プリンシパル・リサーチ・サイエンティストのJie Tan氏の解説によると、本モデルは研究段階のデモンストレーションとして公開されたものであり、実際の人間社会のような乱雑で狭い環境(Cluttered Environments)における実作業の自動化を目指しています。等倍速かつ完全自律(Autonomous 1x)で稼働する映像を通じて、物理世界とAIモデルが高度に融合した「フィジカルAI」の領域における大きな前進を実証しています。
発表された機能・アップデートの全容
Embodied Reasoning ModelとVLAモデルによる二層構造制御
Gemini Robotics 2の核となるのは、高度な文脈理解と高頻度の物理制御を切り分けた二層構造のAIシステムです。上位層には「Embodied Reasoning Model(身体性推論モデル)」が配置されています。このモデルがカメラ映像などの視覚情報、人間からの自然言語命令、さらにカレンダーなどの外部デジタルデータを統合して状況を認識し、適切な高レベルのプランニングを行ないます。
計画が策定された後、下位層に位置する「VLA(Vision-Language-Action)モデル」が呼び出されます。VLAモデルは、視覚入力と指示に基づいて、ロボットの足先から指先までの関節アクチュエータに対して微小な制御指令を生成します。これにより、周囲の環境や物体の位置関係を理解しながら、スムーズな連続動作を実行できるようになります。
カレンダー連携と自然言語による複雑タスクの自動分解
動画内のデモでは、研究者が「今日、子供たちがスポーツをするので準備を手伝ってほしい」と口頭で雑な指示を出す場面が描かれています。ロボット「Apollo」は、この発言を受けると自律的にカレンダーの予定を参照しました。画面上には「14:00 Jessie pickleball match」「16:00 Jeremy baseball game」という2つのスケジュールが表示されます。
ロボットは、Jessieにはピックルボールのパドルとボール、Jeremyには野球のグローブとボールが必要であると自律的に推論しました。そして、棚の前に移動し、混雑した整理ケースの中から該当する道具を正確に選択し、トートバッグへ順番に収納していく一連のタスクを人為的な指示介入なしで完遂しました。
瞬時の姿勢崩れを復元するリアルタイム全身バランス補正
二足歩行ロボットが前傾姿勢で棚の奥にある物体へ手を伸ばす際、重心が偏って前方へ倒れそうになる物理的な課題が存在します。Gemini Robotics 2では、体幹が前に傾いた瞬間に、脚部のアクチュエータを瞬時に後方へ押し戻すといった全身補正動作を1秒の何分の一(fraction of a second)という極めて短い時間枠で計算・実行します。
従来の手作業によるプログラム制御では、予期せぬ重心変化に対応することが難しく転倒の原因となっていました。本モデルでは、指先の細かな操作と脚部によるバランス保持を単一のニューラルネットワーク上で協調させることで、不確定要素の多い動作中であっても安定した立位姿勢を維持し続けます。
視覚フィードバックによる失敗検知と自律的なリカバリー動作
ロボットが透明なケースから穴のあいたプラスチック製ボール(ピックルボール)を摘み上げようとする際、指先が滑ってボールを落としてしまう不具合が発生しました。Gemini Robotics 2は、視覚フィードバックを通じて「目標の捕捉に失敗した」という事実を即座に認識しました。
システムはエラーを検知すると、処理を中断することなく即座に手を元の位置に戻し、角度を微調整してボールを再度掴み直す補正動作を自動的に実行しました。失敗時の処理を個別にプログラミングすることなく、閉ループ制御(Closed-loop control)によって自律的な試行錯誤と目標達成を実現しています。
高所・低所へのアクセスを可能にする動的な屈み・持ち上げ動作
デモの後半では、研究者が「左側の床に置かれたトートバッグを探し、拾い上げてテーブルの上に置いてほしい」という追加タスクを提示しました。ロボットは視覚センサで床面をスキャンしてバッグを発見すると、膝を深く折り曲げてしゃがみ込み、両腕でバッグの持ち手を掴んで立ち上がりました。
重さのあるバッグを持ち上げる際には、腕の筋力だけでなく背中や脚の運動を連動させて重心を維持し、そのまま指定されたテーブルまで歩行してバッグを安定して配置しました。このような高さの変化を伴う大がかりな運動も、すべてモデルの推論結果として自然に出力されています。
性能・ベンチマーク
動画内で明確に示された定量的指標および質的評価基準は以下の通りです。数値化されたベンチマークのスコアシートは動画内に含まれていないため、一部は映像および音声解説からの事実に基づき構成しています。
| 項目名 |
定量データ・仕様 |
出典 |
Note |
| 制御モード |
全身協調制御(Whole-Body Control) |
動画内テロップ(0:22) |
足先から指先までの全関節を統合制御 |
| 稼働状態 |
完全自律・1倍速(Autonomous 1x) |
動画内テロップ(0:17) |
遠隔操作や動画の倍速編集なし |
| 主な構成モデル |
Embodied Reasoning Model + VLA |
登壇者Jie Tan氏発言(0:40) |
二層のAIアーキテクチャを採用 |
| バランス補正速度 |
1秒の何分の一(Fraction of a second) |
登壇者Jie Tan氏発言(1:15) |
リアルタイムな体幹・脚部制御 |
| 実証タスク数 |
2種類の複合タスク(荷造り・拾い上げ) |
動画内デモ映像(0:27-2:30) |
スケジュール解釈含む総合実験 |
| ベンチマーク数値 |
動画内での提示なし |
編集部注 |
数値スコアは論文等の補足資料参照 |
競合サービスとの比較
ロボティクス向けAI基盤の分野では、Google DeepMindのほかにも複数の世界的プレイヤーが熾烈な開発競争を繰り広げています。現状の主要な競合ソリューションとGemini Robotics 2の相対的な知見を以下にまとめます。
| 企業名 / モデル名 |
主な制御アプローチ |
優位点 |
課題・弱点 |
出典 |
Google DeepMind
Gemini Robotics 2 |
VLA + 高精度推論モデルによる全身制御 |
マルチモーダルな文脈理解と全身バランス制御の統合 |
複雑な工場環境等での長期運用実績の明示 |
本動画(編集部整理) |
Tesla
Optimus AI |
端対端(End-to-End)ニューラルネットワーク |
自社製造ラインでの実用データを活用した大量学習 |
抽象的な言語指示に基づく長期的計画能力 |
編集部注(公開情報に基づく) |
Figure
Figure 02 |
OpenAIモデル連携による対話と動作生成 |
高度な会話能力と自然な手先操作の融合 |
動的な二足歩行バランス制御の柔軟性 |
編集部注(公開情報に基づく) |
Boston Dynamics
Atlas (Electric) |
強化学習と伝統的制御理論のハイブリッド |
圧倒的な身体能力とアクロバティックな走破性 |
自然言語による複雑な文脈推論の統合度 |
編集部注(公開情報に基づく) |
Gemini Robotics 2の最大の強みは、LLM/VLM由来の「文脈理解能力」と、物理ロボットの「全身バランス制御」がシームレスに結合している点にあります。TeslaやBoston Dynamicsが身体能力やハードウェア最適化に強みを持つのに対し、DeepMindはカレンダー検索や状況からの道具推論といった「思考」と「運動」を直結させた点で差別化を図っています。
料金・提供プラン
今回の公式動画内では、Gemini Robotics 2の商用ライセンス価格、API利用料金、ならびに一般開発者向けの提供時期に関する具体的な発表はありませんでした。これまでのGoogle DeepMindによる研究成果の公表パターンを考慮すると、まずは提携するロボティクスメーカーや研究機関向けに限定的なプライベートベータとして提供され、将来的にGoogle Cloudプラットフォーム等を通じてAPIや開発ツールキット(SDK)の形で展開される可能性があります。(編集部注)
日本から使う方法
現段階でGemini Robotics 2はGoogle DeepMind内部の実験および特定ハードウェア(Demoで使用されたApollo等のヒューマノイド)上で稼働している研究モデルです。一般ユーザーが直ちにAPIを呼び出したり、WebUIから利用したりすることはできません。
日本のエンジニアや研究者が今後の展開に備えるための推奨ステップは以下の通りです。
- 公式特設サイト(deepmind.google/gemini-robotics)にアクセスし、最新の技術論文および技術ブログの情報を更新通知に登録する。
- Google Cloud Vertex AIで提供されている既存のGemini Visionモデルやマルチモーダル機能を活用し、視覚と言語を組み合わせたロボット制御プロトタイプの開発を進めておく。
- ROS 2(Robot Operating System)などの標準的なロボット制御フレームワークにおいて、VLAモデルからのアクション出力を受け取るインターフェース設計の知見を蓄積する。
誰にどう効くのか
エンジニア・研究者へのインパクト
従来、ロボットの制御は「高レベルの計画(AI/LLM)」と「低レベルの関節制御(制御工学/PID制御等)」に分断されており、その間の変換レイヤーの設計が極めて困難でした。Gemini Robotics 2が提示したVLAによる全身制御手法は、制御プログラムの大部分をデータ駆動型モデルへ置き換えられる可能性を示しており、開発工数の劇的な削減が期待されます。
企画・新規事業担当者へのインパクト
単なる作業の自動化にとどまらず、「人間のあいまいに言った指示」や「デジタル上のスケジュール」を解釈して実動作へ落とし込める点がポイントです。家事代行、介護補助、商業施設の複雑な清掃・補充作業など、これまで自動化が不可能とされていた多品種少量・非定型タスク市場へのロボット導入シナリオが現実味を帯びてきます。
経営層・投資家へのインパクト
労働力不足が深刻化する日本市場において、汎用型人型ロボット(General-purpose Humanoid)の実用化時期は重要な経営指標です。ハードウェア専用の制御ロジックに依存せず、AIモデルのアップデートによってロボットの運動能力が飛躍的に向上する「ソフトウェア定義型ロボティクス(Software-Defined Robotics)」の到来を証明する発表と言えます。
まとめ
Gemini Robotics 2は、AIの持つ「推論力」とロボットの「身体性」を解体することなく統合した、フィジカルAIの重要な到達点です。転倒補正や失敗検知に見られるように、現実世界の物理的変化に対して即座に適応する能力は、ロボットが研究室を出て人間社会へ共存するための必須要件となります。ロボティクス関連事業に携わるプレイヤーは、モデルのAPI開放やオープン化の動向を注視し、自社のハードウェアや受託現場への適用可能性を早期に検証することが推奨されます。