最新人口1人あたりの売上高で見る日本の地域産業
AI・テクノロジーGoogle

Gemma 4のゲーム勝率、学習中に95%へ Tunixの実例を公開

Google Developers 公式発表公開 読了 2分
Gemma 4のゲーム勝率、学習中に95%へ Tunixの実例を公開

画像:Google Developers(公式発表より)

Gemma 4とTunixを使ったゲーム実験で、学習後の勝率は95%に達しました。

  • 6×6の盤面で、隠れた飛行機の8マスを23回以内に探す課題を使いました。
  • Cloud TPU v6e-8の1台で学習し、複数のゲームを同時に進める構成を示しました。

Plane Strikeの条件と学習結果

項目 数値・内容
盤面と飛行機 6×6マス、飛行機は8マス、向きは4通り
ゲームの終了条件 飛行機の8マスをすべて当てるか、23回調べる
学習前 未使用盤面で勝率9.4%、平均22.44回の攻撃
学習中 100ステップの学習で勝率約95%、平均約16回の攻撃
学習中の1ステップ 8種類の盤面で各8回ゲームを実施

すぐにできること

  1. Plane Strikeの完全な学習コードを開き、環境・道具・学習処理のファイルを確認する。
  2. Tunixに用意された道具連携の仕組みと、今回の独自実装を見比べる。
手順と公式の窓口を見る

なるほど

同じ盤面での反復と、行動の判定方法

公式ページで確かめた、知っておくと役立つこと

  • 学習時のGRPOでは、同じグループの8回のゲームをまったく同じ盤面で実施します。異なる盤面の結果を比べる設定ではない点は、公開コードを読む際の確認ポイントです。
    出典・developers.googleblog.com
  • 公開実装では、モデルの応答から有効な攻撃呼び出しが1つだけ確認できた場合に有効な座標として扱い、それ以外は「INVALID_ACTION」になります。勝率だけでなく、行動の判定方法も確認できます。
    出典・developers.googleblog.com

一般利用者向けの新機能を追加する発表ではありません。

今回の対象は、エージェント(自分で手順を進めるAI)です。結果を受け取るたびに次の行動を選ぶよう、Gemma 4 E2Bを追加で学習させました。

題材の「Plane Strike」は、6×6の盤面に隠れた飛行機を探すゲームです。AIは1マスを調べる道具を呼び出し、当たりか外れかを見て次のマスを選びます。飛行機を構成する8マスをすべて当てるか、23回調べると終了します。

学習前のモデルは、学習に使っていない盤面で勝率9.4%でした。平均で22.44回の攻撃を要しました。

Googleによると、100ステップの学習中に勝率は約0.20から約0.95に上がりました。平均の攻撃回数は約16回になりました。

ただし、約95%は学習中の値です。学習前の未使用盤面での値とは、同じ条件で比較した結果ではありません。
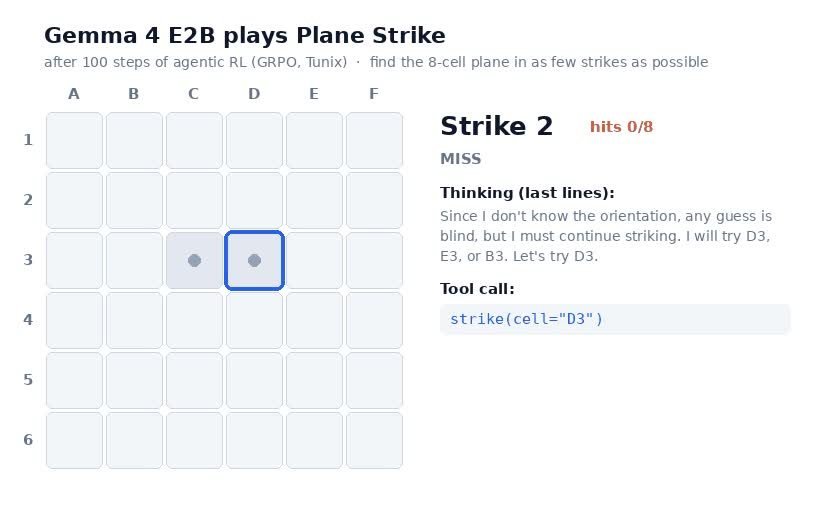
Google Developersの発表の図(Gemma 4のゲーム勝率、学習中に95%へ Tunixの実例を公開)
画像:Google Developers(公式発表)

Tunixの使い方 盤面の反応を次の行動につなぐ

Tunixは、AIモデルの追加学習に使う仕組みです。今回の例では、報酬を手がかりに行動を改善する「強化学習」を使いました。

学習方法にはGRPO(複数の行動結果を比べて学ぶ手法)を採用しました。同じ盤面で8回のゲームを行い、その結果を学習に使います。1ステップでは8種類の盤面を扱いました。

Gemma 4は道具を呼び出すと、結果が返るまで生成を止めます。盤面の情報を受け取ると、同じ応答の中で考え方と次の操作を続けます。学習中は、正しい道具の呼び出しが約100%に近づきました。

計算にはCloud TPU v6e-8の1台を使用しました。モデルやゲームの進行を担う処理が8個のチップを共有します。vllm-tpuを使い、複数のゲームを非同期で進める構成です。

現在の構成では、ゲーム内の各攻撃が同じ一連の行動に対する報酬を共有します。Googleは、各手の貢献をより細かく評価すれば、さらなる改善が可能だと説明しています。

Plane Strikeの条件と学習結果

表は記事の最初(要点の下)にあります

サイソクの見方:95%はゲームの条件と合わせて見る

AIエージェントの学習方法を検討するなら、Tunixの公開コードで盤面と道具をつなぐ構成を確認するとよいでしょう。一方、業務での性能を判断したいなら、Plane Strikeの勝率だけでなく、自分の課題で評価する必要があると考えられます。

判断ガイド公開結果を導入判断に使うとき2つの迷いに、状況ごとのおすすめと理由開く

判断ガイド

公開結果を導入判断に使うとき

状況ごとのおすすめと理由です。どれを選ぶかは、ご自身の状況で決めてください。

95%の勝率を業務導入の根拠にできる?

状況
Plane Strike以外の課題で性能を判断したい
おすすめ
自分の課題でも評価する
理由
この結果はPlane Strikeでの学習後の勝率で、ゲームは6×6の盤面と隠れた8マスの飛行機を使います。業務の課題で同じ性能が出るとは示されていないため、自分の環境で確かめる判断が必要です。
出どころ
出典・developers.googleblog.com

道具連携を独自に実装するべき?

状況
標準的な複数手順の道具連携を作る
おすすめ
まずTunixの既存機能を確認する
理由
TunixにはToolEnvironment、ToolAgent、ToolManagerが用意されており、独自のメッセージや観察の受け渡しを実装せずに使えます。独自のターン制御が必要な場合は、個別実装が選択肢になります。
出どころ
出典・developers.googleblog.com

不安Q&A

勝率やゲームの条件はどう見る?

学習後の平均攻撃回数はどれくらい減った?

Googleの発表では、学習前は平均22.44回、100ステップの学習後は約16回の攻撃でした。ゲームは飛行機の8マスをすべて当てるか、23回攻撃すると終了します。

出典・developers.googleblog.com

今できること公開コードのenv.pyを開き、ゲームの終了条件と攻撃回数の扱いを確認する。

学習中は同じ盤面を何度も使うの?

GRPOのグループでは、8回のゲームが同じ盤面で行われます。発表では、1ステップで8種類の盤面を扱うとも説明されています。

出典・developers.googleblog.com

今できること公開コードのenv.pyと学習処理を開き、盤面のseedとグループ設定を確認する。

道具を呼び出した後、モデルは続けて動ける?

Gemma 4は道具の呼び出し後、tool_responseでいったん生成を止め、結果を受け取ってから同じassistant turn内で次の考えや道具の呼び出しを続けます。

出典・developers.googleblog.com

今できること公開コードのstrike_tool.pyを開き、道具の応答を同じターンに戻す処理を見る。

Tunixではゲーム用の環境を必ず自作する必要がありますか?

Googleによると、一般的な複数の道具を使うAI向けに、環境や道具を管理する仕組みが用意されています。今回のゲームでは、手順を細かく制御するために環境を実装しています。
Gemma 4の学習コードと文書の参照先

Google Developers Blogの発表から、完全なコードを収めたGitHubリポジトリとTunixの文書に進めます。発表には、コードや文書を参照する期限は記載されていません。コードには、ゲーム環境、道具の呼び出し、学習処理の構成が含まれています。

Google Developersの発表を読む

よく読まれている記事

  1. 「フラボス」購入者への返金開始 対象と手続きはニコリオに確認
  2. 楽天ブラックフライデー2026は11月19日20時開始
  3. 令和8年秋の褒章は761人 藍綬443人・黄綬264人、名簿は都道府県別に公開
  4. 藤井風ピアノリサイタル 11月20日の初日をYouTubeで生中継
  5. 三井住友銀行の顧客情報、最大約1,400万件漏えい 氏名・口座は含まず
なぜ起きた?複数手順の学習が必要な背景公式ページが書く原因・背景開く

背景

複数手順の学習が必要な背景

背景には、実際のAIエージェントは1回の応答で仕事を終えるとは限らず、途中の観察をもとに考え、道具を使い、環境からの反応を受けて複数の手順で戦略を変える必要があるという課題があります。

出典・developers.googleblog.com
手順と公式窓口上の「すぐにできること」の手順と、困ったときの連絡先開く

すぐにできること

学習コードと道具連携を確認する

  1. 1

    Plane Strikeの完全な学習コードを開き、環境・道具・学習処理のファイルを確認する。

    1. 1-1Google Developers Blogの発表を開く
    2. 1-2this GitHub repositoryを開く
    3. 1-3env.py、strike_tool.py、train_planestrike.pyを見る
    公式ページを開く github.com
  2. 2

    Tunixに用意された道具連携の仕組みと、今回の独自実装を見比べる。

    1. 2-1Google Developers Blogの発表を開く
    2. 2-2Tunix documentationを開く
    3. 2-3ToolEnvironment、ToolAgent、ToolManagerを確認する
    公式ページを開く tunix.readthedocs.io

仕事での使いどころ

影響:一部の人
  • AIエージェントの開発者は、道具の呼び出しと複数手順の学習を組み合わせた公開コードを参照できます。
  • 実験にはCloud TPU v6e-8を使っています。業務への応用を考える場合は、ゲームでの評価条件を確かめる必要があります。

発表内容をもとにした一般的な情報です。導入や契約の判断は、公式情報を確かめたうえでご自身で行ってください。

研究・デモ段階

サイソクの判定

ゲームでの実験結果として受け止め、構成を再現したい開発者は公開コードを確認できます。

主な対象
AI開発者

11/21時点の判定。発表内容をもとにAIで判定しています。最新の提供状況は公式情報をご確認ください。

出典を見る(1件)・確認方法・更新履歴
出典(公式)
Google Developers Blog「Multi-Turn Agentic Reinforcement Learning with Tunix and Gemma 4 on Google TPUs」
日時
公式発表 サイソク掲載
確認方法
公開前に、本文を出典と自動で照合しています(事実確認 98点/100点、70点未満は非公開)。制作と確認の方法
誤りの報告
お問い合わせから受け付けています。直した記事は訂正履歴に残します。

この記事をシェアする

NEWSLETTER

毎朝7時、暮らしとお金のニュースの要点を5本

前日に出た記事から、給付・税・料金・値上げなど暮らしとお金に関わる話を中心に選び、1本2行でまとめてメールで届けます。無料・いつでも解除できます。

確認メールのリンクを開いた時点で登録完了です。アドレスは配信にだけ使います(プライバシーポリシー)。 配信の内容

大きな速報を、通知ですぐに

主要企業の大きな発表だけ、1日4回まで。夜22時〜朝7時は鳴らしません。いつでも解除できます。

本記事は公式発表の文章をもとにAIが要約・解説して自動生成したものです。誤りが含まれる可能性があるため、正確な仕様・料金は公式発表をご確認ください。元記事を読む制作方法と事実確認の手順は編集方針をご覧ください。誤りのご指摘はお問い合わせから受け付けています。