要約版:専門用語を控えて説明しています
キャッシュの仕組み
AIアプリは、同じ指示文やマニュアルを毎回送ることがよくあります。プロンプトキャッシュは、この同じ部分を覚えておき、次からは読み直さずに使う仕組みです。
キャッシュから読み取った分は、通常の入力より低い料金で請求されます。ただし書き込みの料金は、モデルによっては通常より高くなります。
2つのモード
暗黙的キャッシュは、設定なしで自動的に働きます。会話や、同じ手順をくり返すエージェントに向いています。
明示的キャッシュは、「ここまでを覚える」という区切りを自分で付けます。共通の部分は固定で、質問だけが毎回変わるアプリに向いています。
明示的モードでは、モードの指定と区切りの印の両方が必要です。どちらか片方だけでは、期待どおりに動きません。
使う前に確認すること
対応するモード、最低限必要な長さ、保持時間はモデルごとに違います。使うモデルのモデルカードで確認してください。
Bedrockのオープンウェイトモデルを使う開発者は、これまでの暗黙的キャッシュに加えて、明示的なプロンプトキャッシュを選べるようになりました。Amazon Bedrockを使っていない人や、キャッシュを使わない用途では、何も変わりません。日本での提供状況はまだ発表されていません。
プロンプトキャッシュとは、AIへの指示文の先頭部分を計算済みの状態で保存し、次の依頼で再利用する仕組みです。システムプロンプト(AIへの基本指示)、参考資料、ツールの定義、これまでの会話などが対象になります。AWS Machine Learning Blogによると、再利用が多いほど節約額は大きくなります。
 画像:AWS(公式発表)
暗黙的と明示的、2つのモードの違い
依頼が過去の依頼と同じ内容で始まると、Amazon Bedrockはその先頭部分をキャッシュから読み、残りだけを処理します。キャッシュの読み取りは標準の入力より低い料金です。モデルによっては、書き込みが標準より高くなります。
設定が不要なら暗黙的、保存範囲を絞りたいなら明示的です。
表は記事の最初(要点の下)にあります
Chat Completions APIでは、明示的モードにprompt_cache_optionsのmodeをexplicitにし、prompt_cache_breakpointの印を1つ以上付けます。
 画像:AWS(公式発表)
暗黙的キャッシュは先頭を固定すると効く
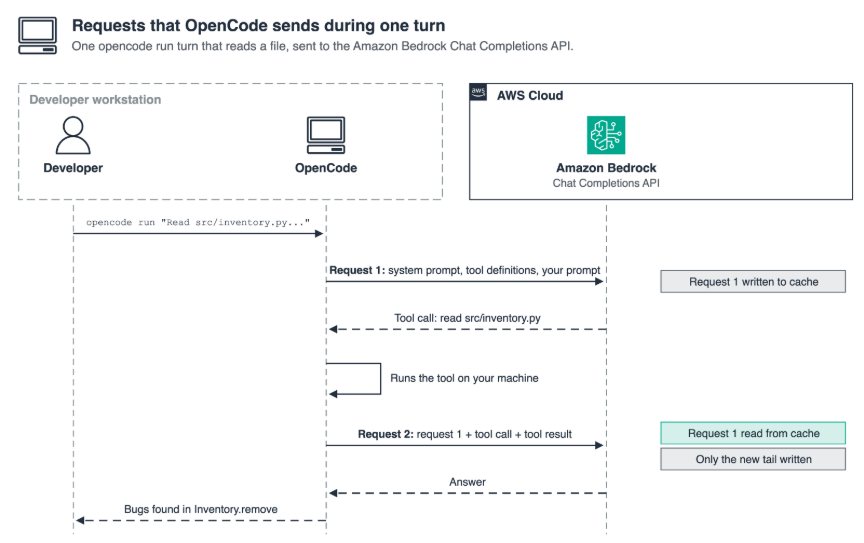
会話では、毎回それまでの全文を送り直します。前の依頼が、次の依頼のキャッシュ済みの先頭になります。
AWSは、固定の内容を先に、変わる内容を後に置くよう勧めています。先頭が変わると、その位置からキャッシュが作り直されます。
サンプルでは、システムメッセージにマニュアルを、ユーザーメッセージに質問を入れています。両方を1つのユーザーメッセージの部分として送ると、暗黙的キャッシュは効きませんでした。
明示的キャッシュで書き込みを絞る
暗黙的モードでは、次回以降に使われない内容もキャッシュに書き込まれることがあります。毎回変わる質問が典型です。
共通部分の後ろの内容が毎回変わるなら、明示的キャッシュで書き込みを共通部分だけに絞れます。最後の区切りより後ろは標準の入力料金です。書き込みが高いモデルでも、読まれない内容に高い書き込み料金を払わずに済みます。
区切りは、変わる頻度の違う層ごとに複数付けられます。上限はモデルによって違います。
サンプルのコードの要点は次のとおりです。
- システムメッセージの本文を、テキスト部分として渡す
- そのテキスト部分にprompt_cache_breakpointのmodeをexplicitにして付ける
- extra_bodyでprompt_cache_optionsのmodeをexplicitにして送る
- モードだけで区切りが無いと、何もキャッシュされない
- 区切りだけでモードの指定が無いと、暗黙的キャッシュのように動く
キャッシュの保持時間(TTL)は、キャッシュに当たるたびにリセットされます。ttlの指定値は、モデルカードで確認します。
使い方:キャッシュの効き方を確かめる
AWSのサンプルは、架空の浄水器「AnyCompany AquaPure 500」のサポートアシスタントです。約4,000トークンのマニュアルを共通の先頭にして、3つの質問を送ります。
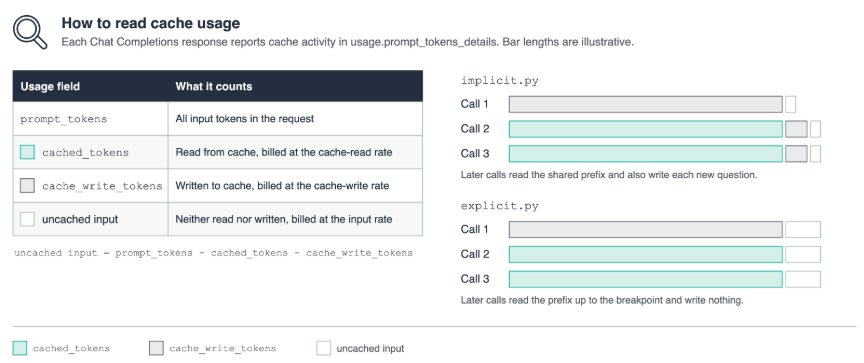
応答の使用量(usage)にあるprompt_tokens_detailsで、キャッシュの動きが分かります。読んだ量がcached_tokens、書いた量がcache_write_tokensです。
暗黙的モードの初回実行は、次のようになります。
- 1回目は、プロンプトをキャッシュに書き込む
- 2、3回目は、マニュアルをキャッシュから読む
- 2、3回目は、新しい質問の分として数トークンを書く
- 最後のメッセージの後ろの数トークンは、毎回キャッシュされない
TTLの間に再実行すると、すべての呼び出しが読み取りになり、書き込みは発生しません。明示的モードでは、2、3回目の書き込みがありません。
準備に必要なものは次のとおりです。
- 選んだモデルを使えるAWSアカウント(対応リージョンはモデルごとに違う)
- そのモデルを呼び出せるIAMの権限
- Python 3.12と、openaiの3.26.0以降、aws-bedrock-token-generatorの1.1.0以降
- エージェントの例では、OpenCode 1.18.35を入れるnpm
認証は、aws-bedrock-token-generatorのprovide_token()で、AWSの認証情報から最長12時間有効の短期APIキーを作ります。長期のキーを作って保管する必要はありません。
マニュアルは、モデルカードの最低限のプレフィックスの長さを超える必要があります。サンプルでは、ダミーの文章でもよいとされています。キャッシュに必要なのは同一の先頭だけだからです。推論モデルが返す推論用のトークンも、max_tokensに含まれます。
料金とプライバシーの扱い
入力トークンは、キャッシュ書き込み、キャッシュ読み取り、標準入力の3つのレートのどれかで請求されます(Amazon Bedrockの公式ドキュメント、11/17確認)。Amazon Novaの暗黙的キャッシュの再利用は例外です。各モデルの料金は、Amazon Bedrockの料金ページにあります。
Bedrockのほかのモデルと同じく、プロンプトと出力はモデル提供元と共有されず、モデルの学習にも使われません。
モデルによって違うこと
BedrockのOpenAIモデルは、対応するAPI経由で暗黙的キャッシュを使えます。GPT-5.6以降のモデルは、明示的キャッシュにも対応します(Amazon Bedrockの公式ドキュメント、11/17確認)。
Anthropicのモデルは明示的キャッシュに対応し、キャッシュコントロールの無いリクエストはキャッシュされません。保持時間は5分と1時間です(同、11/17確認)。
Mistral Large 3は、bedrock-runtimeエンドポイントで暗黙的キャッシュに対応しています(AWS Machine Learning Blog、11/17確認)。Anthropic向けの解説にある明示的キャッシュの設定は、オープンウェイトモデルにそのまま当てはまりません。
サイソクの見方:まず暗黙的で測り、変わる質問が多いなら明示的へ
会話や、同じ手順をくり返すエージェントのように、先頭が安定している用途なら、まず設定の要らない暗黙的キャッシュで効果を測るのが手堅いと考えられます。
AquaPureの例のように、共通のマニュアルに毎回違う質問が続く用途で、書き込みが高いモデルを使うなら、明示的キャッシュで共通部分だけを書き込む方が無駄が出にくいとみられます。
どちらの場合も、使うモデルのモデルカードで対応モード、最低限の長さ、TTLを先に確認するとよいでしょう。