要約版:専門用語を控えて説明しています
4台をつなぐだけで使える
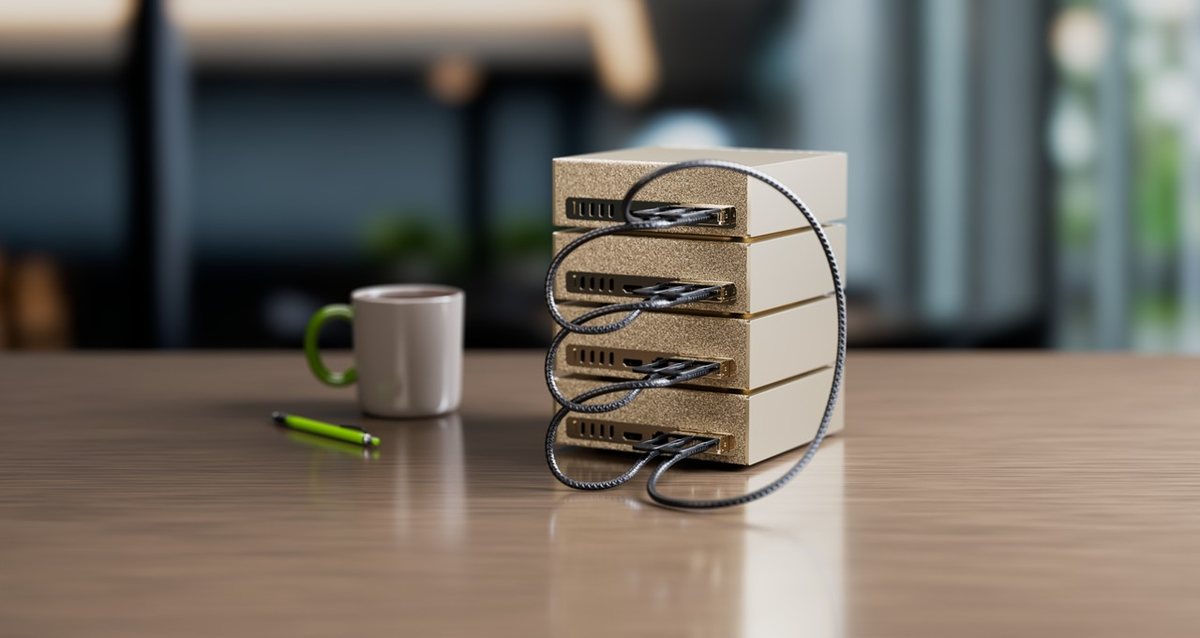
このキットは、4台のDGX Sparkを、となり同士で直接つなぐ構成です。ネットワークスイッチ(機器をつなぐ装置)は要りません。
4台あわせて、メモリは512GB、保存容量は20TBです。NVFP4という方式を使うと、最大700Bパラメーター(AIの規模を表す数)のモデルを手元で動かせます。
順番待ちを減らせる
ふだん研究者は、共有のGPUクラスターの順番を待ちます。このキットなら、開発と動作確認を手元で進め、共有サーバーは本番の計算に取っておけます。
未発表の研究結果や社内のデータも、自分たちの設備の中に置いたまま使えます。
買える場所
SC26の会場で展示され、販売も始まっています。Acer、ASUS、Dell Technologies、GIGABYTE、H3C、HP、Lenovo、MSI、xFusionなどのパートナーとNVIDIA Marketplaceで買えます。価格と日本での提供はまだ発表されていません。研究用ソフトの導入手順書(HPC SDKのプレイブック)は近日公開の予定です。
このキットが関係するのは、共有のGPUクラスターで順番待ちをしている研究者や開発者です。ふだん単体の机上機で足りている人には、何も変わりません。
「DGX Spark HPC Developer Kit」は、小型AIコンピューター「DGX Spark」を4台つないだ研究・開発用のキットです。NVIDIA公式ブログによると、SC26(米シカゴで開かれる年次のスーパーコンピューター会議)で発表されました。
4台をスイッチなしで直結した構成
キットは4台のDGX Sparkで構成します。各台は両隣の2台と、リング状に直接つながります。接続にはNVIDIA ConnectX-7(高速ネットワーク機能)を使います。ネットワークスイッチ(機器をつなぐ装置)を買って設定する必要はありません。
1台から4台まで、段階的に増やせます。中核は、GB10 Grace Blackwell Superchipです。
4台でそろう主な数字は次のとおりです。
- 合計メモリ: 512GB
- NVMeストレージ: 合計20TB
- 実行できるモデル: NVFP4で最大700Bパラメーター(例としてDeepSeek V4.1)
NVFP4は、モデルを小さく表現して動かす形式です。記事によると、こうした容量を使い、モデルや計算を4台に分けて載せられます。
順番待ちを減らし、非公開データも手元に
計算資源の割り当てが決まっている研究者は、これまでジョブのたびに順番を待つ必要がありました。このキットなら、開発とデバッグ(不具合探し)を自分たちで進められます。
その分、サーバーの利用時間は本番の計算に回せます。未公開の結果や独自のデータセットも、社内の設備に置いたまま使えます。
近日公開のHPC SDK手順書と動作実績
NVIDIA HPC SDKは、GPUで高速化したC、C++、Fortranのコンパイラーとライブラリ、MPIのツールです。MPIは複数台で計算を分担する通信の仕組みです。スーパーコンピューターで使うものと同じ開発ツールです。
DGX Sparkクラスター向けの導入手順書(プレイブック)は近日公開予定です。公開後は、4台でアプリを作って試し、通信の問題を大型システムに移す前に洗い出せます。
4台での動作が示された例は、LAMMPS(Kokkos使用、材料シミュレーション)とNAMD(分子動力学)です。DGX Sparkのコミュニティーでは、次のソフトの動作も確認されています。
- GROMACS(分子動力学)
- OpenFOAM(流体力学)
- WRF(気象予測)
- NVIDIA NIMのOpenFold3、Boltz-2(生体分子の構造予測)
Nemotron 3.5 Super VLには、生命科学と化学向けに調整するための新しいオープンデータセットとポストトレーニングの手順が出ています。
研究室の使い方と事例
公式ブログは、使い道をいくつか挙げています。
- エージェントが、シミュレーションの入力準備、実行、結果の要約を手伝い、研究者が設定と結論を確かめる
- 遅いシミュレーションを近似するAIを学習し、翼の抵抗を減らす設計に使う
- 1,000万セルのシミュレーションを、重要な50〜500の次元に絞ってからスパコンを使う
具体的な事例も紹介されています。
- Kvantify: 1台のDGX Sparkで、最大70量子ビット・975ゲートの量子化学回路を、cuQuantumのテンソルネットワークで計算。ペニシリンの基底状態エネルギー計算用の回路で検証
- CYRAN AI(IIT Delhi発のスピンアウト): PixelFluxライブラリで、大型衛星画像のJPEG 2000デコードを高速化
- カリフォルニア大学バークレー校Rubin Lab: Evo 2で細菌の特性を遺伝子配列から予測。11時間のクラスター待ちがなく、結果は15倍早く届いた
- 同校Hartwig Group: Nemotron 3 Super 120B-A12BをNVFP4で1台に載せ、LoRAでファインチューニング。8〜24時間の学習を連続で実行
販売先と日本での提供
キットはSC26で展示され、販売も始まっています。DGX Sparkの製品とケーブルは、OEMパートナーとNVIDIA Marketplaceで買えます。
パートナーは、Acer、ASUS、Dell Technologies、GIGABYTE、H3C、HP、Lenovo、MSI、xFusionです。
NVIDIAは10月、DGX Spark 64GBの発売と、手動構成で最大8台のクラスター対応を発表していました(GTC BerlinのローカルAI製品群の記事)。8台構成は1TBの統合メモリです(サイソクの過去記事、11/17確認)。今回の4台キットは、直結の構成を研究向けのセットとして示したものです。
判断ガイド候補に入れるか、急がず待つか迷ったら2つの迷いに、状況ごとのおすすめと理由開く閉じる
判断ガイド
候補に入れるか、急がず待つか迷ったら
状況ごとのおすすめと理由です。どれを選ぶかは、ご自身の状況で決めてください。
共有クラスターの待ちが長いとき、4台キットを候補にする?
- 状況
- 順番待ちやジョブ数が多い
- おすすめ
- 候補に入れて、用途と販売先を確かめてから判断する
- 理由
- 待ちを減らし、本番用のサーバー時間を温存できると説明されています。4台で512GB、NVFP4で最大700Bまでのモデルを扱えるとされています。
- 出どころ
- 出典・blogs.nvidia.com
1台の机上機で足りている人は、買い足す?
- 状況
- 順番待ちをほとんど感じていない
- おすすめ
- 急がなくてよい
- 理由
- ページは、計算資源の割り当てがあり順番待ちが課題の研究者向けに説明しています。順番待ちが少ない人には、用途が合いにくい可能性があります。
- 出どころ
- 出典・blogs.nvidia.com
不安Q&A
1台から増やせる?データは社内に残せる?
Q今の1台のDGX Sparkから、あとで増やせますか?▾
1台から4台まで段階的に増やせる構成だと書かれています。4台はConnectX-7で直接つながり、ネットワークスイッチは不要です。
出典・blogs.nvidia.com今できること1台で始めて、4台まで増やす計画を立て、設置場所を確かめておく
Qネットワークスイッチを別に買う必要はありますか?▾
各台は両隣の2台とリング状に直接つながると説明されています。ネットワークスイッチを買って設定する必要はないとされています。
出典・blogs.nvidia.com今できること4台を並べる前に、両隣と直結するリング状の配線で置けるかを確かめる
Q未公開の研究データを外に出さずに使えますか?▾
未公開の結果や独自のデータセットは、社内の設備に置いたまま使えると説明されています。開発とデバッグも研究チームで進められます。
出典・blogs.nvidia.com今できること未公開データを扱うなら、社内設備に置いたまま使う運用を研究室で決めておく
Qうちで使うソフトは4台で動きますか?▾
LAMMPS(Kokkos)とNAMDは4台での動作が示されています。GROMACS、OpenFOAM、WRFなども、コミュニティで動作が確認されたと書かれています。
出典・blogs.nvidia.com今できること使うソフトが一覧にあるかを確かめ、導入手順書の公開を待つ
QHPC SDKの手順書があると何ができるようになりますか?▾
複数台向けGPUアプリの開発、FP32や混合精度の検討、LAMMPS(Kokkos)での分子動力学と材料シミュレーションを、大型システムに移す前に試せます。