要約版:専門用語を控えて説明しています
少ないデータでも専門知識が身につく仕組み
これまでは、LLMに業界の専門知識を覚えさせるためには、数十ギガバイトを超えるような膨大なデータが必要でした。実際の業務でそれだけの資料を用意することは難しく、これが業務特化型LLMを作る大きな壁になっていました。
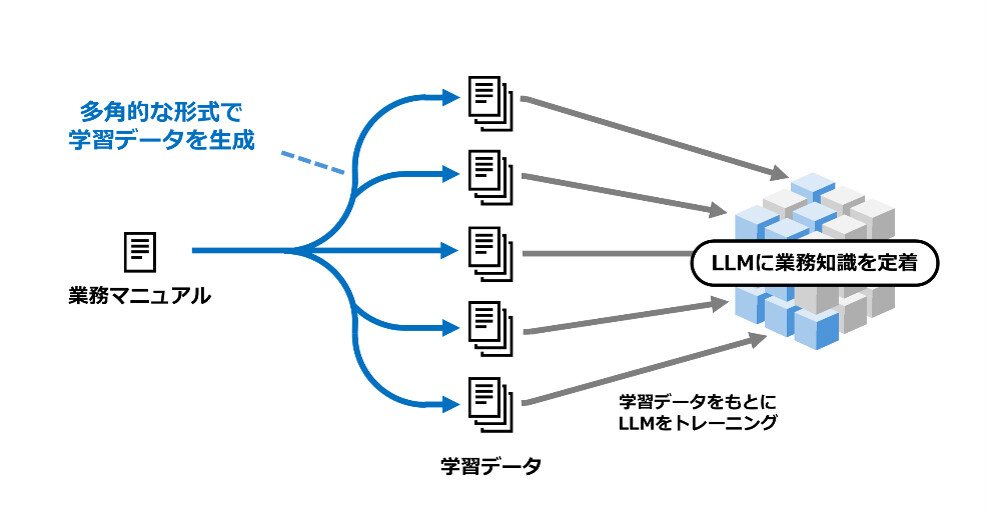
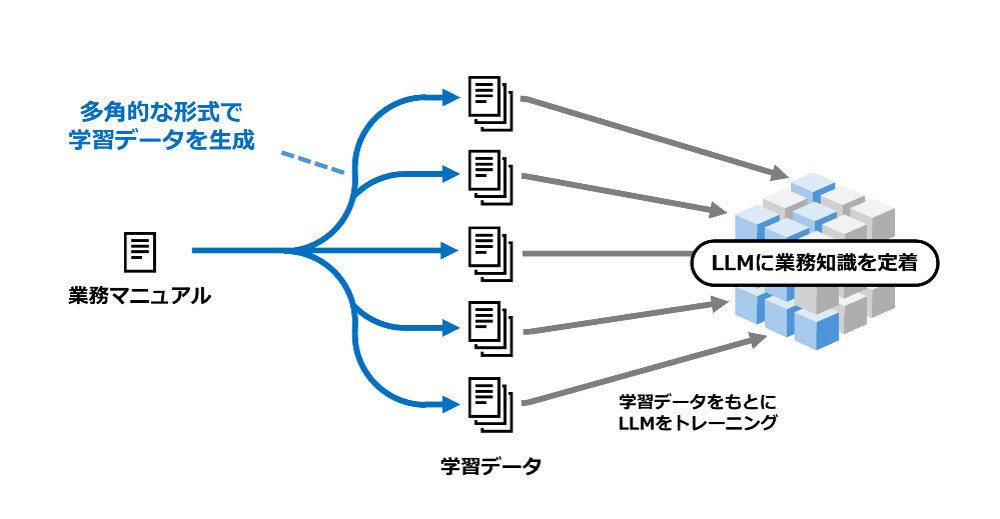
今回開発された技術では、AI自身が業務マニュアルをもとに、問題やFAQといった多様な学習教材を自動で作ります。人間がさまざまな形式の問題を解いて理解を深めるように、AI自身が作った教材で学ぶことで、少ないデータでも高い精度で知識を定着させられるようになります。
実験での成果と今後の予定
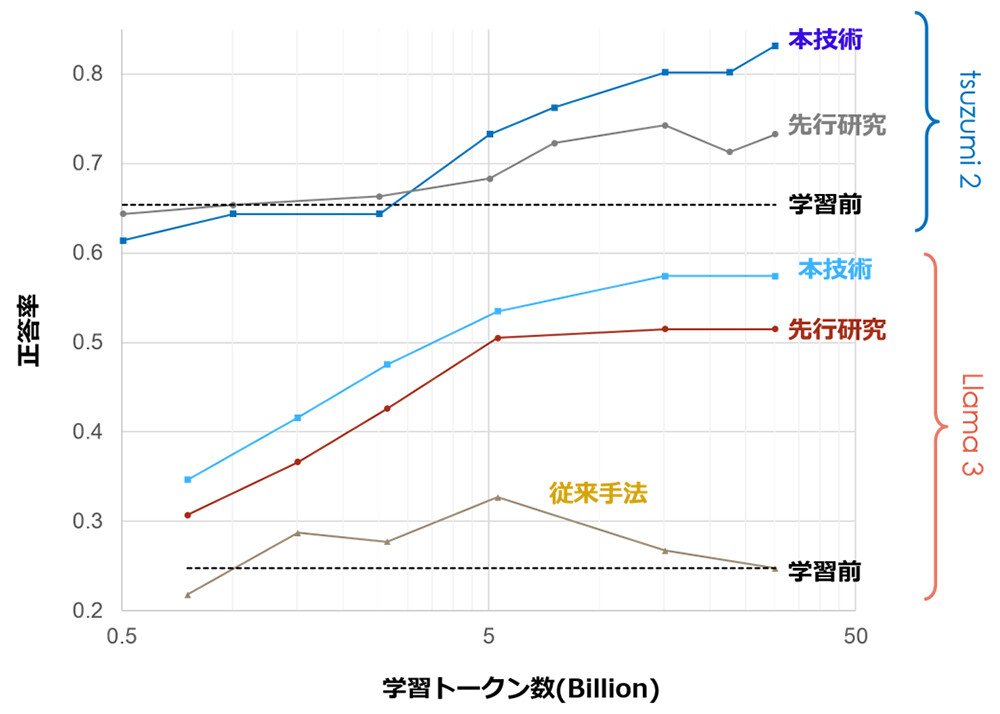
NTTの実業務マニュアルを使った実験では、LLMの「tsuzumi 2」にこの技術を適用したところ、専門知識を問う問題の正答率が83.1%となり、従来の手法よりもさらに向上しました。
本技術は、NTTグループ各社に導入される予定です。また、2026年11月18日から開催される「NTT R&D FORUM 2026」にて展示される予定となっています。
NTTは2026年11月12日、業務マニュアルなどの少量データから、特定の専門知識をLLM(大規模言語モデル)に定着させるチューニング技術を発表しました。
LLM自身が学習データを自動生成する仕組みを使い、業務固有の知識を持つ専用LLMを、従来より少ない準備で構築できるとしています。NTTの「tsuzumi」のほか、他のLLMにも適用可能です。
 画像:NTT(公式発表)
業務の専門知識を覚えさせるには大量のデータが必要だった
LLMを特定の業務やタスクに合わせて調整する作業は、チューニングと呼ばれます。中でも難しいのが、業務マニュアルや専門書などにある専門知識をモデルに覚えさせる作業です。
知識を付与する一般的な手法では、モデル全体を再学習させるために、数十ギガバイトを超えるような大量のデータを使います。実際の業務現場で、それだけのマニュアルや資料を用意するのは困難です。インターネット上から関連情報を集めても、業務と無関係なデータが混ざりやすく、高品質なデータセットを作るのは容易ではありません。
 画像:NTT(公式発表)
マニュアルからFAQなどの学習データをAIが生成
今回の技術は、お客様問い合わせマニュアルなどを基に、LLM自身が多角的な学習データを作り、それを自らの学習に使います。
学校の授業では、文章を読むだけでなく、設問を解いたり感想を述べ合ったりして学びを深めます。同じような着想で、業務マニュアルから仕様書やFAQといった多様な形式のデータを生成します。これらを使って学習することで、従来より高い精度でマニュアルの知識を獲得できるとしています。
tsuzumi 2の正答率は先行研究の最大73.3%から83.1%に
NTTは実業務マニュアルを使い、その記載範囲から作成した問題をLLMに解かせて、正答率を計測しました。検証には「tsuzumi 2」と、より軽量な「Llama 3(3B)」を使用し、それぞれ学習前後の正答率を比較しました。
「tsuzumi 2」の結果は次のとおりです。
- 学習前:65.3%
- 先行研究の手法:最大73.3%
- 今回の技術:83.1%
Llama 3(3B)でも、先行研究の手法より優れた結果を確認したとしています。
不安Q&A
少ないデータで本当に覚えるの?
Q少ないデータでも、本当に社内の知識を覚えるの?▾
NTTの実業務マニュアルを使った実験では、tsuzumi 2の正答率が学習前の65.3%から、新技術により83.1%まで向上したと発表されています。
出典・group.ntt今できること導入を考えるなら、自社の業務マニュアルから問題を作り、学習前後の正答率を比べてみる。
Q従来の方法と比べて、何が楽になるの?▾
従来は数十ギガバイトを超える膨大なデータが必要でしたが、本技術ではLLM自身が仕様書やFAQなど多様な形式の学習データを生成します。そのため、限られたデータ量でも知識を定着させられるとされています。
出典・group.ntt今できることまず、お客様問い合わせマニュアルなど、業務知識が書かれた資料を手元に集めておく。
QどんなAIでも使えるの?▾
本技術はNTTが開発するtsuzumiを始め、他のLLMにも適用可能とされています。軽量モデルのLlama 3(3B)でも先行研究より優れていることが確認されています。
出典・group.ntt今できること11月18日からのNTT R&D FORUM 2026で、本技術の説明を直接聞いてみる。